Hierarchical Diffusion Policy (HDP)
Hierarchical Diffusion Policy for Kinematics-Aware Multi-Task Robotic Manipulation (CVPR 2024).
Overview
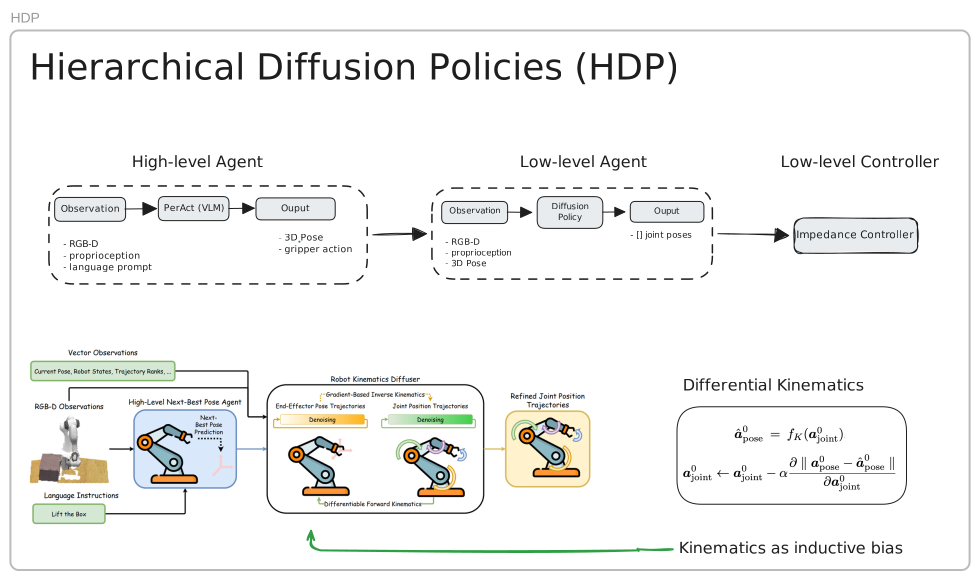
Hierarchical Diffusion Policy (HDP) is a hierarchical imitation learning framework that decomposes complex, multi-task robotic manipulation into kinematics-aware sub-goal planning and fine-grained trajectory generation.
Standard end-to-end diffusion policies often struggle with long-horizon tasks and out-of-reach poses due to compounding error and kinematics ignorance. HDP introduces a dual-level architecture: a high-level diffusion model predicts 3D end-effector sub-goals conditioned on scene observations, while a low-level policy generates continuous, kinematically feasible trajectories. This separation ensures robust multi-task generalization and high execution success across simulated and real-world manipulation benchmarks.
Summary Poster
Authors
Xiao Ma · Sumit Patidar · Iain Haughton · Stephen James
Publications & Resources
Conference Paper (CVPR 2024)
X. Ma, S. Patidar, I. Haughton and S. James, “Hierarchical Diffusion Policy for Kinematics-Aware Multi-Task Robotic Manipulation,” Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024, pp. 18081–18090.
Citation
@inproceedings{Ma_2024_CVPR,
  author    = {Ma, Xiao and Patidar, Sumit and Haughton, Iain and James, Stephen},
  title     = {Hierarchical Diffusion Policy for Kinematics-Aware Multi-Task Robotic Manipulation},
  booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
  year      = {2024},
  pages     = {18081--18090}
}